故事要从这里说起
高中时比较懒(现在也挺懒的),作文除了考试的时候会动脑子想之外,其余的时候都是抄的。但又怕老师发现,所以通常是当作文裁缝,把几篇作文的内容缝在一起交差。
当然这还不够省时省力,好在那时网上已经有用大语言模型写作文相关的应用,有很多网站有部署,并且免费使用,所以我的作业很轻松就能应付过去了(笑)。这大概是我最早接触大语言模型的时候。
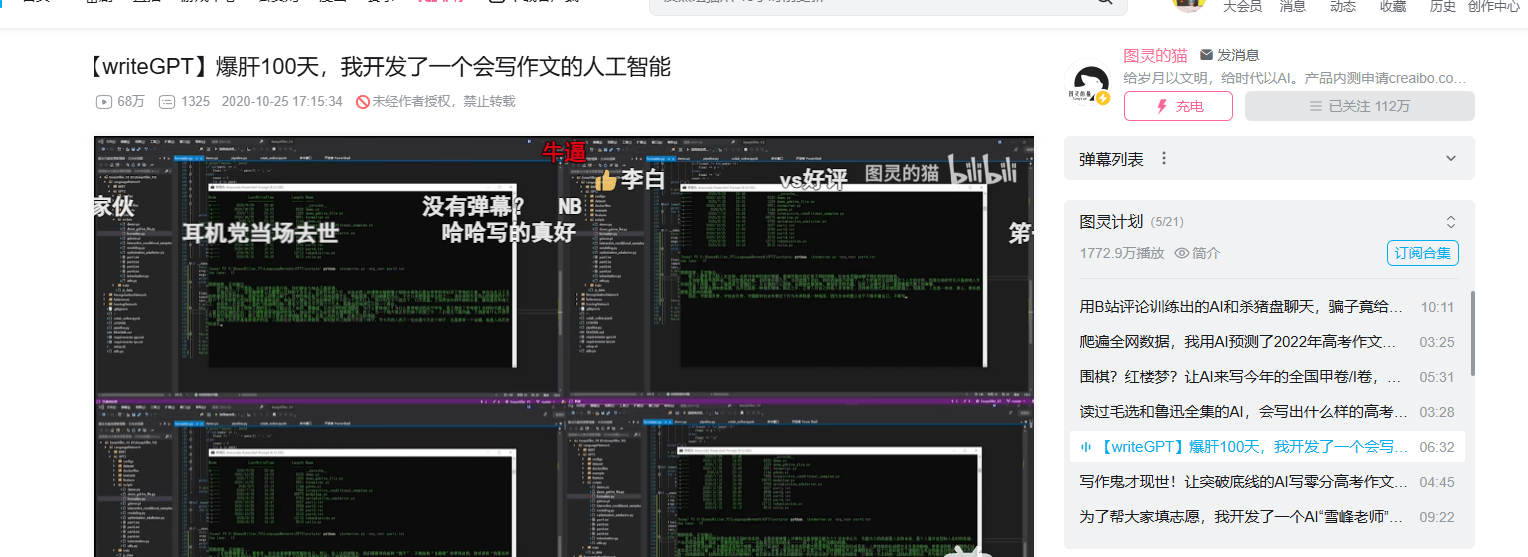
在随后的几年里,ChatGPT的问世可以说是让大语言模型的发展真正进入了一个拐点,它以一种人工智能助手的形式真正走入了大众的日常里。在后续几年的时间里,DeepSeek-R1的广泛出圈、豆包的大众化推广,直到看到我的父母也开始用起了AI相关的应用,我逐渐意识到AI已经深深走入我们的生活了。
近两年Agent的发展十分迅速,已经到了让软件工程师们的生产力飞跃,让工作方式发生变革的恐怖程度了。Agent的发展当然也离不开大语言模型的发展,所以出于对大语言模型的神秘充满好奇,我做了一些关于大语言模型是如何训练出来的学习和研究,将自己的理解和记录进行整理,并以一个科普向的叙述写下这篇文章,欢迎大家批评指正!
总的来说,大模型的训练分为三个阶段:预训练,后训练--监督与微调,后训练--强化学习,后文我们会一一聊到。
预训练
预训练数据集
就像人类学习新事物一样,需要阅读大量的资料,吸收知识。为了让模型内部有丰富的知识,我们需要为其准备学习资料。大量高质量并具有多样性的文本资源作为模型的学习资料,这些内容被称为预训练数据集
数据集主要由网页抓取数据组成,通过爬虫工具从互联网抓取公开的网页文本,但是互联网的内容十分庞大,这些数据很可能包含大量的质量低下的文本,可能充斥着广告、乱码、个人隐私等内容,那么如何广泛的提取并过滤出有效的文本则是准备预训练数据集的关键。
FineWeb是一个由HuggingFace推出的开源大语言模型预训练数据集
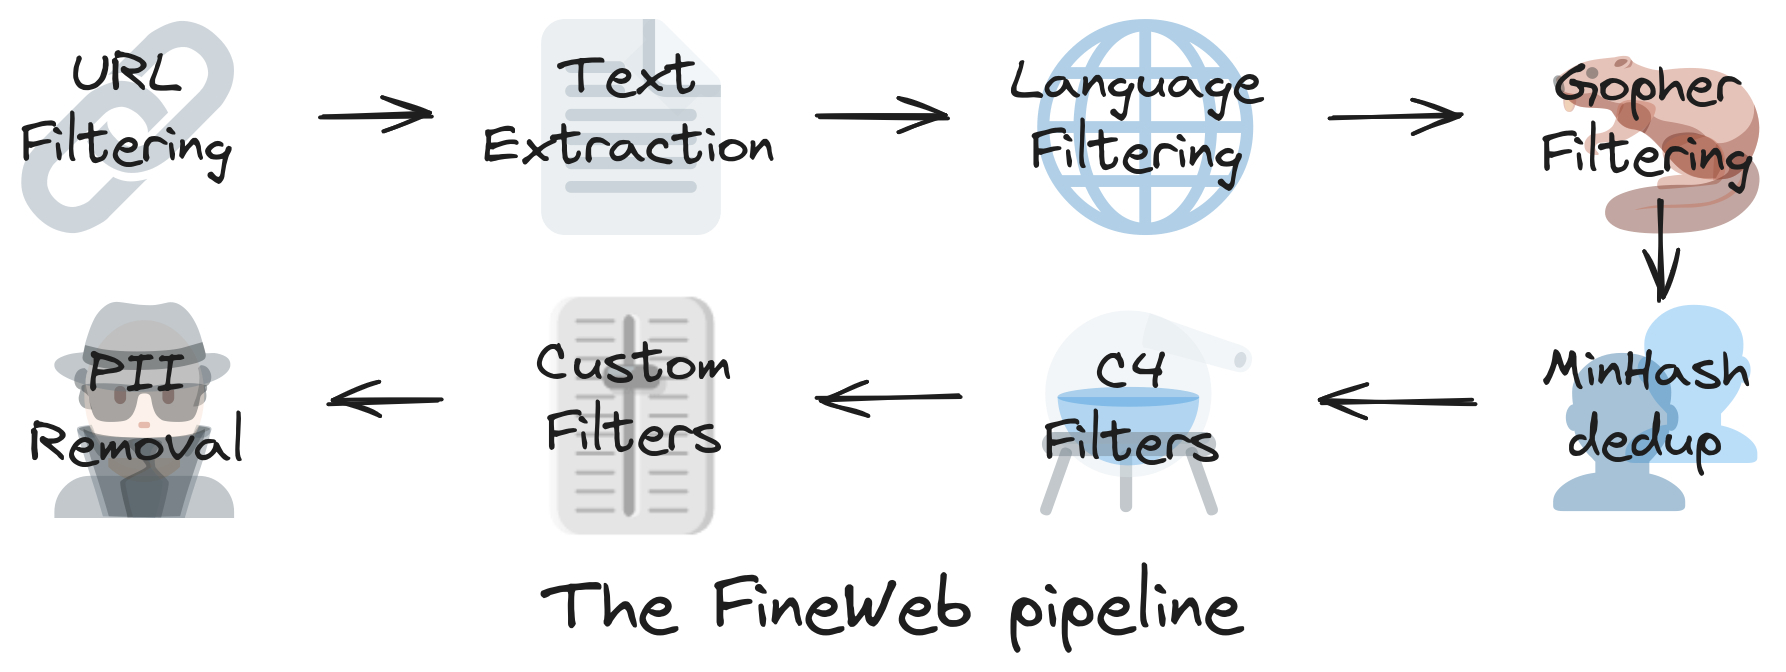 以FineWeb举例,它的文本提取流程,可以简单描述为通过URL网址抓取HTML代码,然后通过一系列的过滤规则,来筛选出高质量的文本信息,大致流程可以简化为如下步骤:
- URL过滤:清除文本中的网页链接(如
https://...)。这样做是为了去掉杂乱的互联网地址,只保留纯文本,避免这些无意义的字符干扰机器理解。 - 文本提取:网页上通常有很多广告、导航栏或排版代码(如HTML标签),这一步就是把这些“噪音”剥离,只把真正的文章或对话内容拿出来。
- 语言过滤:如果你的目标是训练一个中文模型,这一步就会通过算法把混合在里面的英文、日语或其他语种的文本自动识别并删掉。
- 去重数据:互联网上有很多抄袭、转发或重复生成的文本,去掉这些重复内容可以节省存储空间,并减小对模型训练质量的影响
- 删除个人身份信息:自动识别并处理掉文本中包含的姓名、电话号码、身份证号、家庭住址或银行卡号等,通常会用
[姓名]或[电话]这样的标签代替,以保护个人隐私和数据安全。
词元化(Tokenlization)
我们准备好了训练模型所需要的文本资料,但这些数据是以人类文字的形式存在的,计算机是无法直接理解这些文本,也无法用于计算,我们还需要做进一步处理。
想象一下我们最开始学英语时。直接理解一个复杂段落或句子显然不是一个好主意,我们需要先学习字母和发音,再是单词,最后才是理解完整的句子。同样的,大语言模型也需要经历这一个过程,这个过程我们将其称为词元化(Tokenlization)。
词元化的主要目标是将大量的文本分解成更易于机器理解和处理的最小单元,这些最小单元我们就将其称为词元(也就是Token),我们的目的是让机器能认识Token,以便让机器能够理解和响应人类输入的内容。
我们有这样一个句子:
Chatbots are helpful
当我们将句子按照单词进行分词后,就会得到一个个独立的标记。
["Chatbots", "are", "helpful"]
当然这里需要注意的是,这里的词元化是一种最简单的方式,也就是通过单词中间的空格直接拆分文本。对于大语言模型,词元化并不仅仅以单词为单位,词组、字符、单词的子词等都有可能被拆分为词元。
例如使用Tiktokenizer 这个网站对上面这句话进行词元化,可以看到他将Chatbots将Chat和bots拆分为了两个Token,并赋予了他们他们一个独特的数字ID。这整个将一段话转化为ID序列的过程,就是词元化。我们为每个Token都分配一个ID,模型使用这些ID来识别每个词。
Chatbots are helpful ->> ["Chat", "bots", "are", "helpful"]->[16047, 63005, 527, 11190]
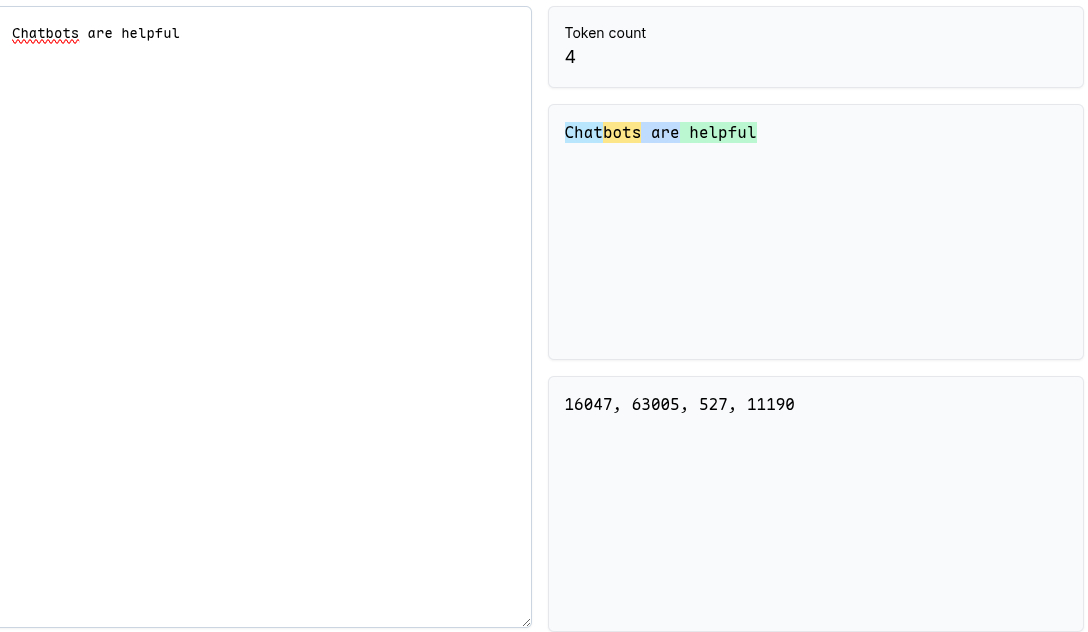
通过词元化,我们最终会得到一个词汇表。词汇表是大模型处理文本的密码本,规定了模型能认识哪些最小单位,并为每个单位分配了一个唯一的数字身份证,也就是ID,从而让神经网络能够进行数学计算。这样,我们就相当于让模型能够认识单词了。
GPT4的词汇表包含100277个Token
训练与推理
现在,我们已经准备好了模型所需要的学习资料,也教会了模型认识单词,接下来就要开始训练模型了。训练大模型的目标非常简单,让LLM可以根据前文预测下一个词,让Token在序列中一个接一个出现。
而模型训练总的流程来说就是将一段文本,通过词元化步骤后,转化为一段词元序列,然后将词元序列输入到神经网络中
- 随机的选取一个词元窗口(任意一段Token序列),我们将其称为上下文(大模型的输入是一个可变长度的Token序列,其最长长度范围被称为上下文窗口大小)
- 将这个Token序列输入到神经网络中,神经网络会输出一个巨大的向量,这个向量就代表了下一个Token的概率分布
- 接下来我们会根据正确答案(例如正确答案是POST“3962”),通过某些方法调整和更新神经网络,使得正确答案的概率更高,而参考答案的标准正是我们的预训练数据集,也就是我们的学习资料
这里神经网络是一个非常大的主题,本文不会深入涉及。总的来说,你可以将神经网络理解为巨大的数学表达式,设计有效的数学表达式是神经网络架构研究的主题
经过训练后,模型的产物被称作基座模型(Base Model)。简单进行一个比喻,基座模型就是一个对互联网的文本信息进行有损压缩后的超级文本自动补全工具,能进行文本的延续,但还不足以做到对话助手的程度。我们前面提到的在ChatGPT之前,用来写作文的模型,就属于一种基座模型。
后训练--监督微调
ChatGPT在诞生时能引起这么大的轰动,除了算力规模的极大提升之外,还有一点很关键的点就是引入了监督微调。监督微调(Supervised Fine-Tuning,简称 SFT) 是后训练的第一步,是将基座模型作为文本补全工具转化为AI助手的关键步骤。
预训练让模型学习到语言的规律、世界知识、推理雏形,但他并不能作为对话助手理解指令。基座模型本质只是互联网文本的概率生成器,如果你输入“2 + 2 等于多少?”,它可能会补全“3 + 3 等于多少?“ 而不是直接回答4。
监督微调这一阶段的训练方式与预训练实际上本质上没有太大区别,唯一不同的是替换了数据集。预训练数据集是互联网文本数据,而在监督微调阶段的数据集则被替换为了人类镜像构建和筛选的对话和问答的文本数据来进行熟练
SFT 的数据通常是:
- 指令:请把“你好”翻译成英文
- 回答:Hello
为了让模型区分是用户在说话还是助手在说话,一般是通过引入特殊的协议Token,例如在GPT-4o中,对话会被编码为包含特殊标记的单维Token序列
<|im_start|>user\n{提问内容}<|im_end|><|im_start|>assistant\n{回答内容}<|im_end|>
监督微调阶段主要教会模型遵循指令、对话格式、语气风格、安全边界等内容。数据量通常远远小于预训练,但质量非常关键,所以需要人为把关。在这样的机制下,诞生了负责筛选和构建对话的人类标注员的特殊职位,标注员通过构思各种各样的用户提问,严格按照指南来编写最佳的助手回答。
==这里可以补充一个OpenAI的构建指南== 当然也可以通过与更高智能的模型对话来构建这样问答数据。我之前参与过一个外包兼职,兼职内容是与Claude当时最强力的模型对话,如果单轮会话的对话质量达标,就可以获得这一次会话的报酬。我猜这些对话数据正是作为监督微调的训练数据集,拿去训练其他AI的。
后训练--强化学习
预训练为模型提供了广泛的知识范围,监督微调帮助它遵循指令。但这两种方式都无法完全解决开放式生成中的质量问题。很多任务并没有一个标准答案
- 写一段解释,哪种更清晰?
- 回答一个问题,哪种更礼貌、更有帮助?
- 做数学题,哪种推理更加可靠?
强化学习阶段,会通过让模型以试错+奖励打分的机制,让AI学会更符合人类偏好或特定目标的回答方式。早期ChatGPT有时会一次性输出多个答案,然后让用户选择质量更优的答案,也算是一种基于线上用户的使用数据,来进行强化学习的过程
强化学习是一种基于人类反馈来进行学习的技术,将人类反馈纳入奖励功能,使模型执行任务时更符合人类的目标、期望和需求。过程大概是:给一个问题 → 模型生成回答 → 奖励模型打分 → 强化学习算法更新模型 → 让高分回答以后更容易出现,低分回答更少出现。循环很多次。
当然,除了基于人类反馈,在一些可验证的领域,例如编程、数学等方面进行自我试错探索也是可行的,因为模型的最终输出可以通过确切的数值匹配,那么在模型的强化学习阶段,就会采样不同的解答路径,基于结果进行正向更新,从而增加模型未来选择类似的路径的概率。
现在大模型普遍存在的思维链也是主要因为强化学习这一步自发涌现的,随着试错训练步数的增加,模型发现将计算量分摊到更多的Token上能显著提示解题正确率,在这个情况下,逐渐演化出了类似于人类内心独白和思考的机制,通过自我质疑,多视角校验、回溯反诉和纠正前文错误。
大语言模型心理学
参数记忆
在预训练阶段,通过反复阅读成百上千次高频的互联网知识,模型可以较为准确地复述,类似于人的模糊记忆,而对于低频的冷门的知识,参数记忆往往不可靠
上下文窗口
而直接输入到上下文窗口中的Token构成了模型的工作记忆,这部分信息直接参与神经网络的前向计算。因此,直接将参考资料或长文本粘贴到上下文窗口让模型总结或提取,其准确度与可靠性是远远高于模型内部的参数记忆的。这也是为什么现在Agent需要依赖实际的代码库。本质上是需要足够的前置信息来对任务进行处理,这一点,对于人类来说也是一样的。
幻觉与知识分配
幻觉产生的原因,在SFT阶段,人类标注员给出的示范回答总是自信且内容准确的,导致模型可以学习并模仿这种自信回答的格式。所以当遇到未知的概念或虚构的问题时,模型为了维持这种格式,则会概率性地编造事实。
解决这种问题可以从两个方面入手,一个是针对参数记忆本身,在训练数据集中加入针对未知事实回答“我不知道”等针对性样例,从而让模型学会表达不确定性。另一个方面是在上下文中,通过引入特殊协议的Token(简单来说就是调用工具),触发外部搜索引擎,将实时的,可信度高的内容抓取并装载到上下文窗口中,这也是大语言模型在接入Agent能展现如此强大的能力之一。可以说大语言模型决定了一个上限,而Agent的强弱则决定了我们能多么接近这个上限
Tokenizer带来的一些问题
神经网络接收的输入并非原始的字符或图像,是经过字节对编码切分后的Token ID,所以针对一些特别的问题,即使是十分顶尖的模型,也会出现失效的场景:
- 拼写与字符处理:模型无法“看见”字母,只能看到 Token 整体。因此在统计单词
"strawberry"中有几个字母'r',或者提取单词第 3 个字母时经常出错 - 计数能力:模型无法在单次生成中直接进行视觉/文本点数(例如统计一串点
....的数量)
对于这些问题,让模型编写Python代码,交给确定性的程序去精确计算是很简便并直接的解决方法。
引用
https://www.youtube.com/watch?v=7xTGNNLPyMI
https://developer.nvidia.cn/blog/mastering-llm-techniques-data-preprocessing/
https://huggingface.co/datasets/HuggingFaceFW/fineweb
https://huggingface.co/spaces/Ki-Seki/blogpost-fineweb-v1
https://www.datacamp.com/blog/what-is-tokenization
https://learn.microsoft.com/en-us/dotnet/ai/conceptual/understanding-tokens
https://medium.com/thedeephub/all-you-need-to-know-about-tokenization-in-llms-7a801302cf54
https://www.datacamp.com/blog/what-is-tokenization
文章评论
使用 GitHub 登录后即可评论、回复和点赞。评论将公开显示。
正在加载评论…
在 GitHub 查看讨论